
Case study pozycjonowania strony agencji edukacyjnej: z jednego kraju na dziesięć
Strona sprzedawała jeden kraj, choć agencja pracowała z dziesięcioma. Po pięciu dniach miała 180 nowych podstron, semantykę dla każdego rynku, llms.txt i 91 zamiast 61 punktów PageSpeed.
Klient
Branża
Usługi
Strona internetowa
Problem
Agencja dobiera uczelnie i programy, prowadzi rekrutację, zajmuje się wizą studencką i legalizacją pobytu. Zarabia na prowizjach uczelni i szkół językowych oraz na płatnym wsparciu przy legalizacji. Serwis prowadzę od lipca 2024 roku: w repozytorium 334 commity, z czego 332 moje.
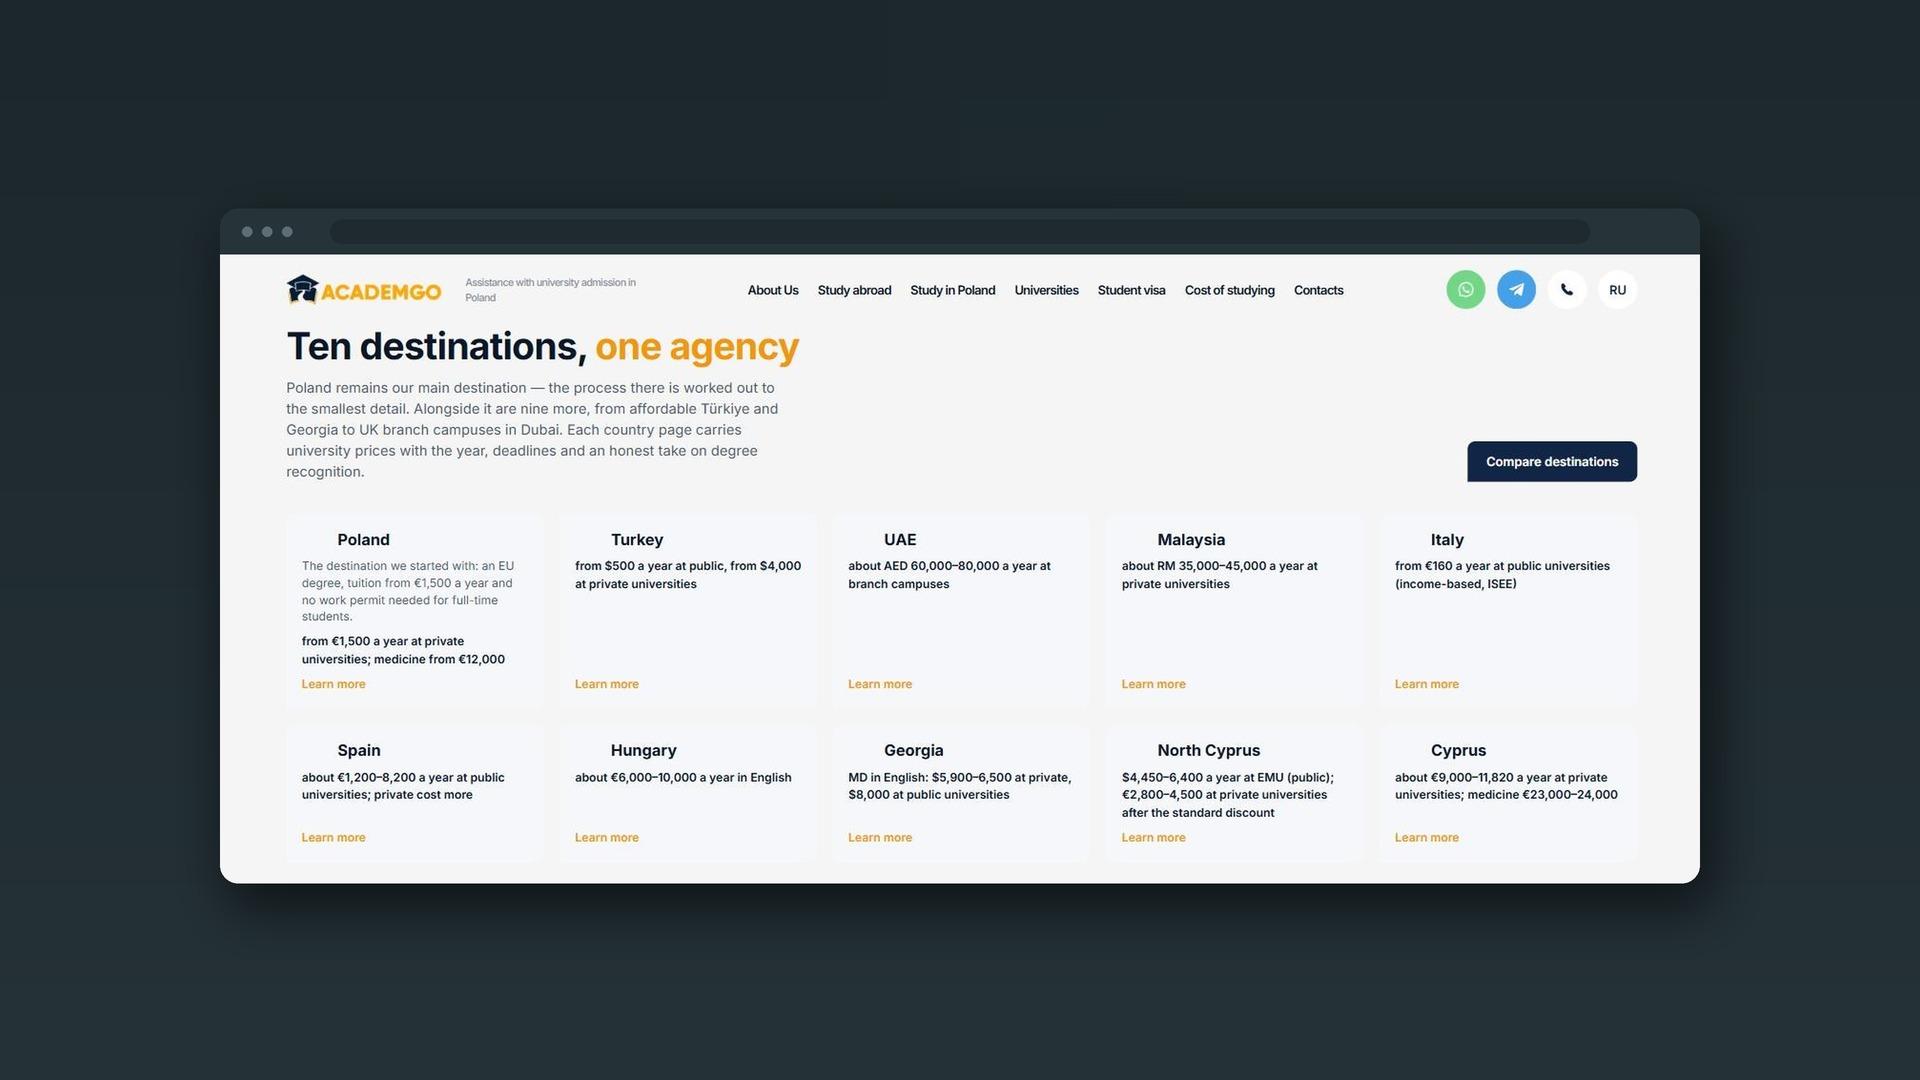
Problemem nie była sama strona, tylko to, co sprzedawała. Cała część produktowa i wszystkie ceny dotyczyły Polski, a sekcje uczelni leżały pod adresami w rodzaju /universities-in-poland/. Tymczasem ludzie, którzy trafiają do agencji, pytają o znacznie więcej: zapotrzebowanie rosyjsko- i anglojęzycznych odbiorców rozkłada się na dziesięć kierunków, od Hiszpanii i Włoch po Malezję i ZEA. Agencja umiała je obsłużyć. Strona nie mówiła o nich ani słowem.
Punkt wyjścia, zmierzony przed publikacją nowych podstron: 18 fraz w pierwszej setce w Polsce i ani jednej w pierwszej dziesiątce, 7 w Kazachstanie, 13 w Azerbejdżanie, 26 w Indiach, 8 w Pakistanie, 5 w Nigerii. Dla Uzbekistanu, Kirgistanu, Rosji i Białorusi baza nie ma danych, więc 24 zapytania sprawdziłem ręcznie — ani jednego wejścia do pierwszej setki. Na 156 fraz docelowych dla nowych podstron domena nie rankowała w ogóle.
Zadanie
- Zamienić stronę jednego kraju w stronę dziesięciu, nie psując tego, co działało dla Polski
- Zebrać semantykę dla każdego rynku i języka zamiast tłumaczyć polskie teksty
- Zaprojektować strukturę podstron, którą da się zbudować skryptem, a nie ręcznie
- Przygotować serwis pod wyniki Google i pod odpowiedzi asystentów AI
- Sprawdzić, co z oferty wolno obiecywać, zanim powstaną podstrony, które to obiecują
- Dodać punkty zbierania zapytań dopasowane do nowej oferty
- Nie stracić szybkości przy wielokrotnie większej liczbie podstron
- Zapisać pozycje wyjściowe przed publikacją, żeby efekt dało się zmierzyć
Wyniki
- Jeden kierunek zamienił się w dziesięć: 180 nowych podstron dla dziewięciu krajów, 188 w jednym potoku razem ze wspólnymi
- Według analityki klienta za wrzesień 2026 ruch i liczba zapytań wzrosły wielokrotnie; klient nie zgodził się na publikację liczb
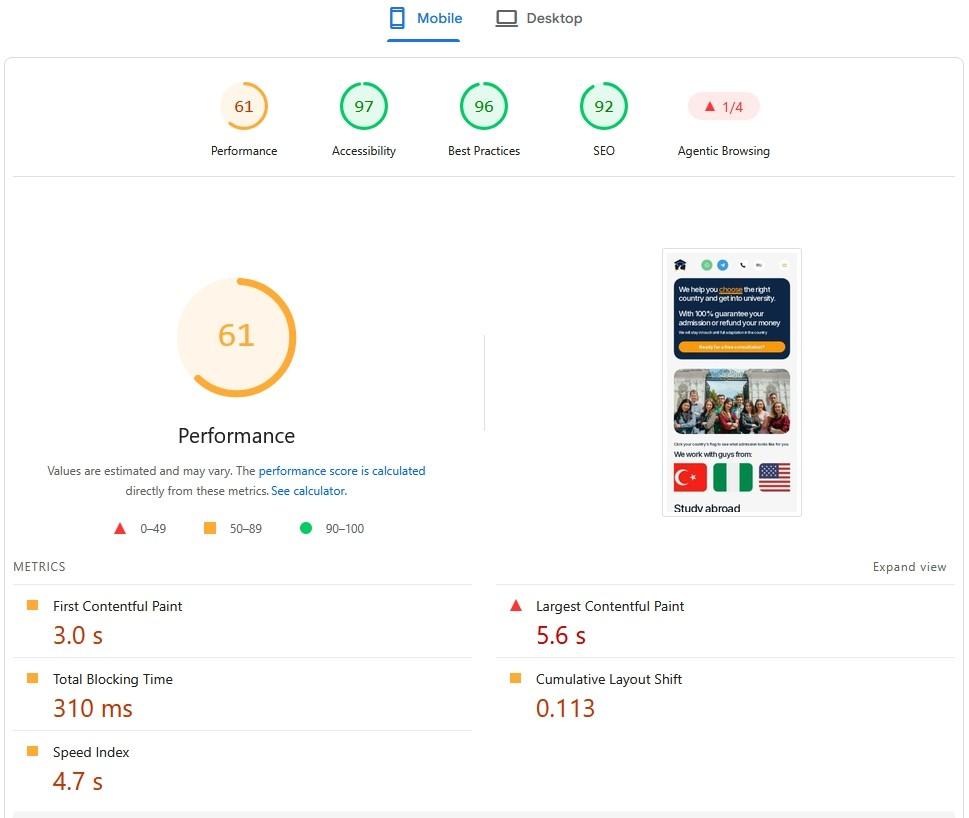
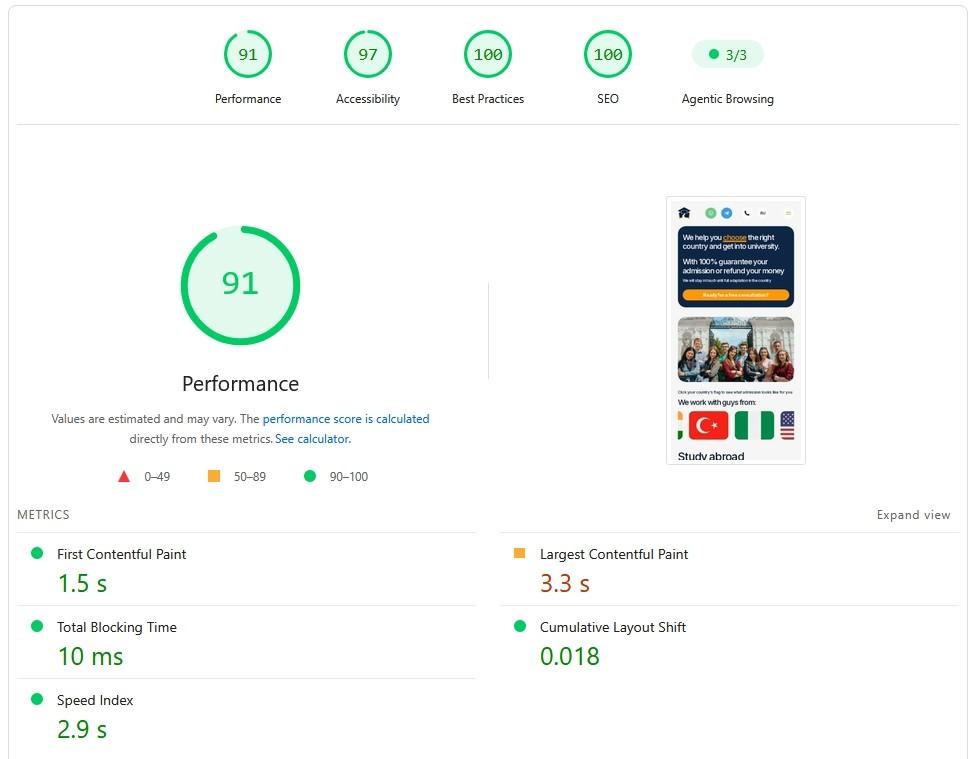
- PageSpeed, pomiar mobilny tej samej podstrony: wydajność 61 → 91, dobre praktyki 96 → 100, SEO 92 → 100
- Wskaźniki ładowania: pierwsze wyświetlenie treści 3,0 → 1,5 s, największy element 5,6 → 3,3 s, czas blokowania 310 → 10 ms, przesunięcia układu 0,113 → 0,018
- Test gotowości na agentów AI po pracach: 3 na 3
- 391 fraz trafiło do roboczej semantyki projektu z około 11 400 angielskich i 1 450 rosyjskich zapytań
- Pozycje wyjściowe zapisane dla 156 fraz docelowych na sześciu rynkach przed publikacją
- Dziesięć poradników PDF jako lead magnety: pięć tematów w dwóch językach
- Sprint przebudowy zajął pięć dni roboczych: 33 commity, 787 zmienionych plików
Wykonana praca
- Analiza eksportów fraz dla dziesięciu kierunków: 88 angielskich i 111 rosyjskich eksportów Keyword Tool, 16 eksportów SEMrush, osobne zestawienia B2B
- Analiza konkurencji w ośmiu krajach w bazie rosyjskiej i angielskiej: pozycje, podstrony, linki, luka słów kluczowych
- Dygest dla każdego kierunku: inwentarz danych, klastry, konkurenci i spisane braki zamiast przemilczanych
- Weryfikacja prawna oferty hiszpańskiej: co wolno, a czego nie wolno obiecywać przy kursach językowych i pobycie
- Model danych w Sanity: słowniki krajów i uczelni, wspólny quiz, huby krajowe i podstrony z powiązanymi wersjami językowymi
- Mapa 20 podstron na każdy kierunek i 180 podstron w dwóch językach zbudowanych jednym potokiem
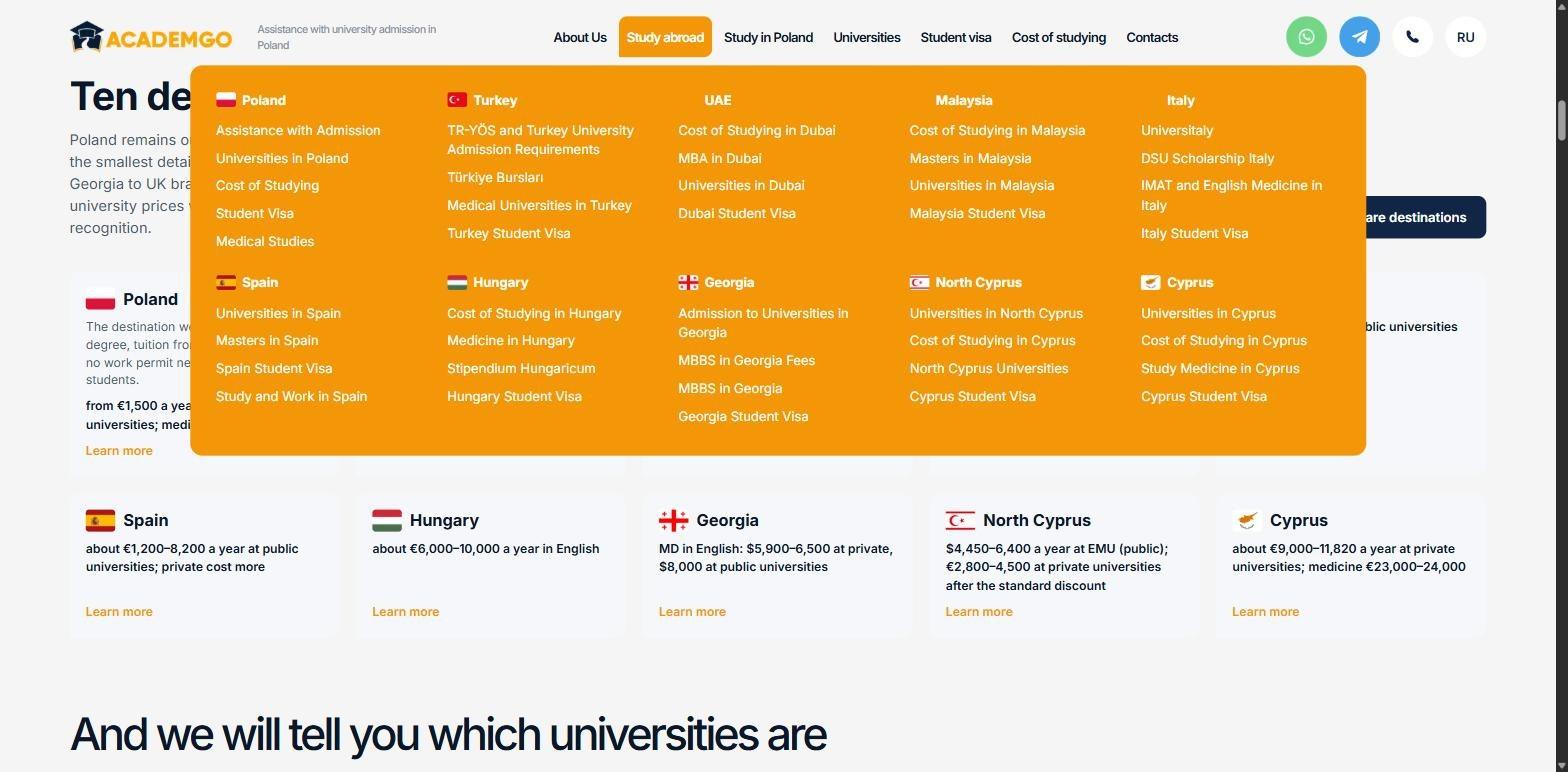
- Przepisana strona główna: blok kierunków, mega-menu na dziesięć krajów, nowe metadane strony głównej i bloga
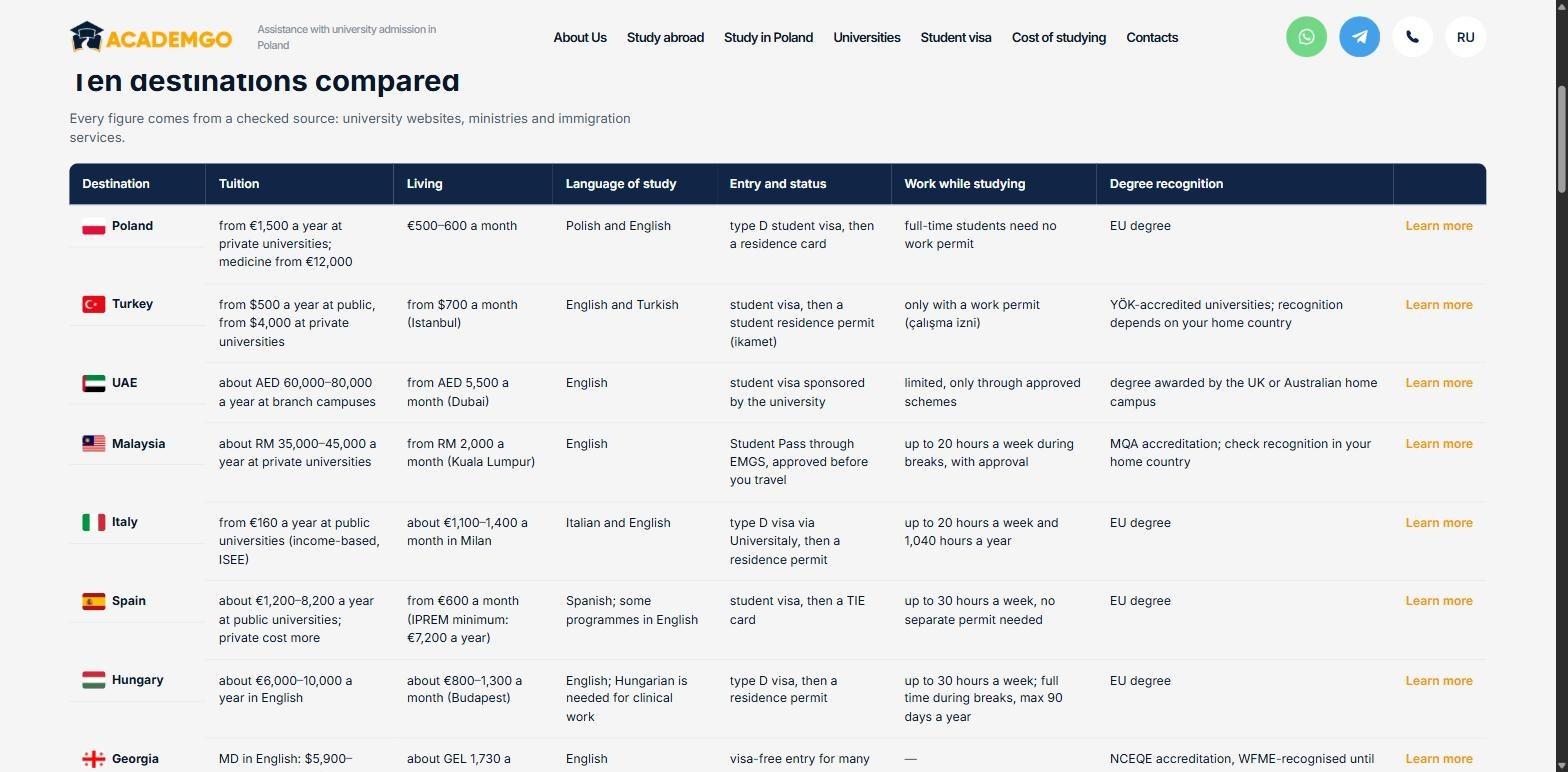
- Strona porównania krajów jako wejście dla tych, którzy jeszcze nie wybrali kierunku
- Linkowanie wewnętrzne między krajami i wewnątrz kraju budowane skryptem, z audytem linków
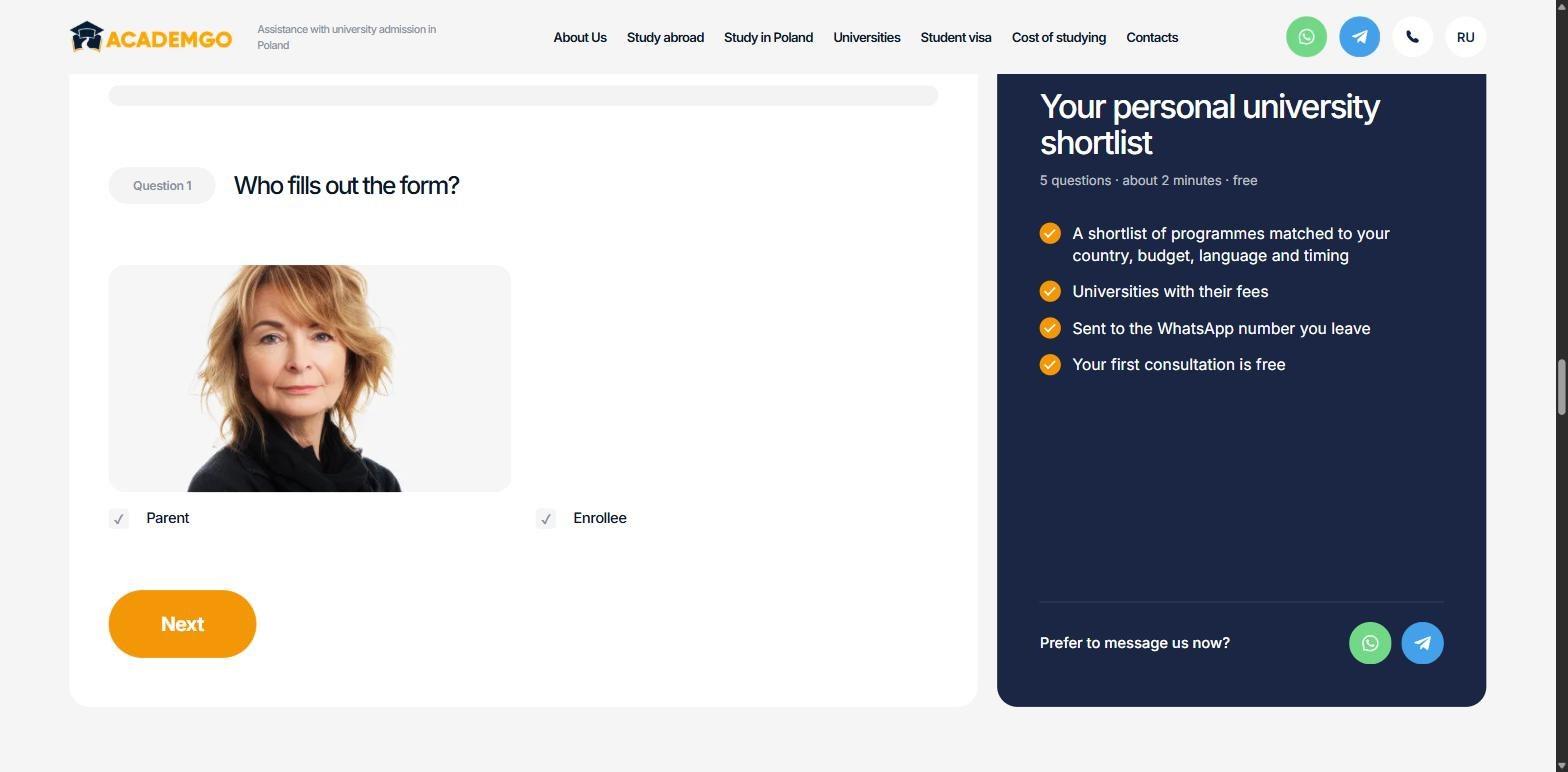
- Quiz na nowych podstronach i pole „kraj studiów” we wszystkich formularzach, zapytaniach i analityce
- Pięć tematów lead magnetów w dwóch językach, dziesięć PDF-ów składanych z markdown skryptem
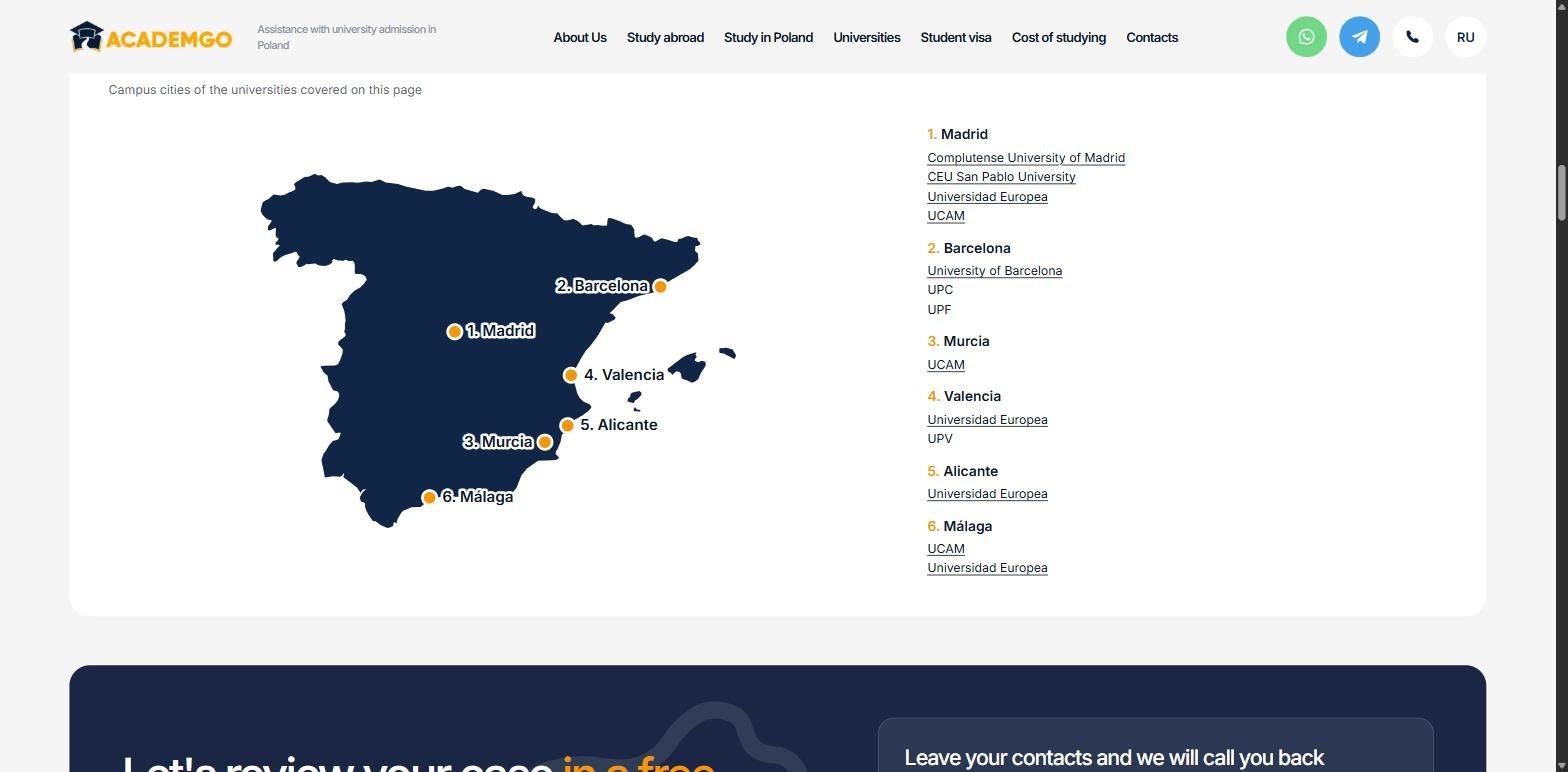
- Infografika na każdej nowej podstronie, z liczbami, współrzędnymi miast i linkami do uczelni sprawdzanymi skryptem
- Podstawa indeksacji: sitemap, hreflang, okruszki nawigacji, noindex na domenach testowych
- Dane strukturalne organizacji, FAQPage i BreadcrumbList na podstronach
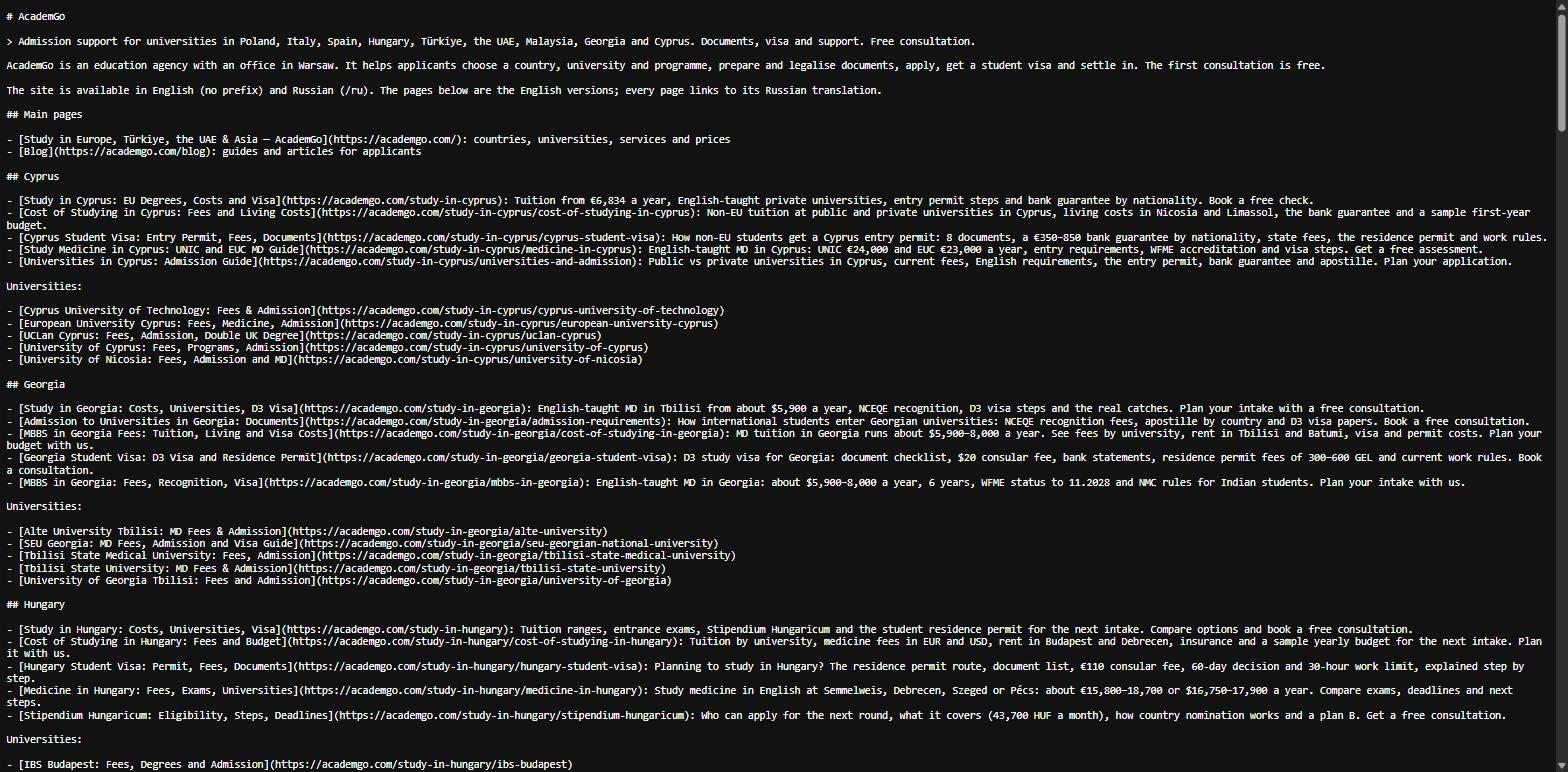
- Plik /llms.txt zgodny ze standardem llmstxt.org, generowany z tych samych dokumentów CMS co podstrony
- Potok publikacji z deterministycznymi identyfikatorami dokumentów i ponownym uruchomieniem bez duplikatów
- Pomiar pozycji wyjściowych dla 156 fraz na sześciu rynkach przed publikacją
- Przyspieszenie: Next.js 16, React 19, Sanity 6, rezygnacja z axios i framer-motion, odroczone ciężkie pola i analityka
- Skrypty QA dla całego zbioru: audyt linków, kontrola podstron, kontrola dat w tekstach
Najważniejsze elementy projektu
Opis projektu
Punkt wyjścia: strona sprzedawała jeden kraj, agencja obsługiwała dziesięć
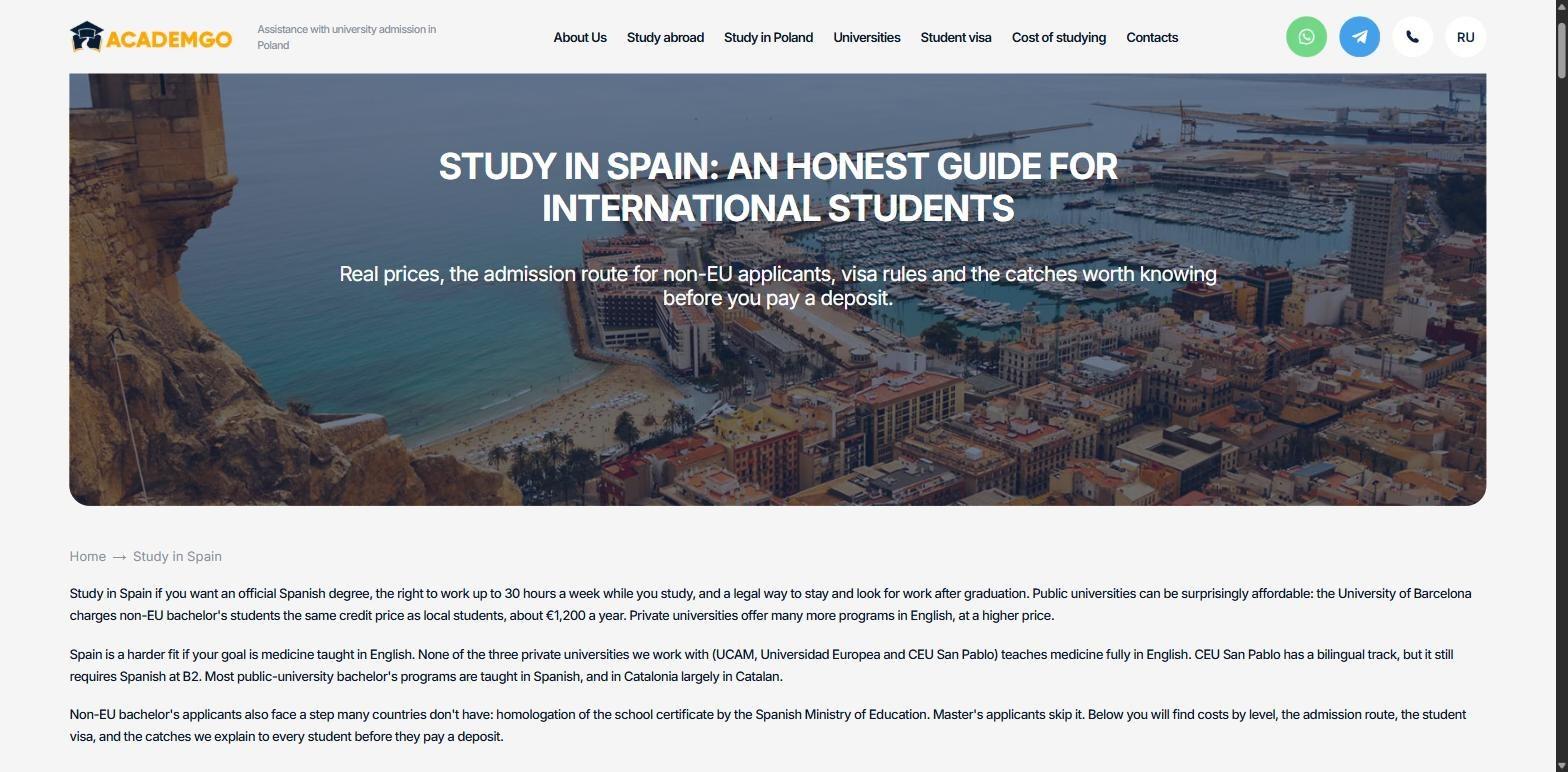
Agencja pracuje z dziesięcioma kierunkami, a serwis mówił o jednym. Ceny, sekcje uczelni, cała część produktowa — wszystko dotyczyło Polski, łącznie z adresami podstron w rodzaju /universities-in-poland/. Ktoś, kto szukał studiów magisterskich w Hiszpanii albo dyplomu w ZEA, nie znajdował tu nic i szedł do konkurencji, która taką podstronę ma.
Zadanie nie brzmiało więc „zrobić redesign”, tylko przepakować ofertę: serwis ma sprzedawać to, co agencja naprawdę robi, i być znajdowany pod pytaniami zadawanymi o każdy z dziesięciu kierunków.
Semantyka dla dziesięciu rynków: 11 400 angielskich i 1 450 rosyjskich fraz
Praca zaczęła się od inwentarza danych, nie od tekstów. Przejrzałem 88 angielskich eksportów Keyword Tool z około 11 400 zapytaniami, 111 rosyjskich eksportów z około 1 450, 16 eksportów SEMrush Keyword Magic i osobne zestawienia o rynku agencyjnym. Obok tego pakiety SEMrush o konkurencji w ośmiu krajach: pozycje, podstrony, linki i luka słów kluczowych wobec tej domeny.
Z tego zbioru do roboczej semantyki projektu trafiło 391 fraz, podzielonych według kierunków i języków. Reszta to duplikaty, szum i pytania kierowane do uczelni, a nie do agencji.
Ograniczenia danych są spisane w dygestach, a nie przemilczane: eksporty Keyword Tool nie zapisują lokalizacji, wolumenów Keyword Tool i SEMrush nie wolno sumować, Yandex nie jest uwzględniony, a część rosyjskich eksportów zdążyła się zestarzeć. To ważne, bo na tych liczbach oparta jest struktura serwisu i za rok ma być widać, które decyzje stały na kruchej podstawie.
Każdy kierunek dostał dygest: co pokrywają dane, czego brakuje, jakie klastry widać i kto zajmuje wyniki wyszukiwania.
Weryfikacja oferty: dlaczego podstrona o kursach językowych w Hiszpanii nie obiecuje pobytu
Hiszpanię rozpisałem osobno: 17 eksportów z 215 frazami, dwa raporty luki, 11 klastrów, mapa 12 typów podstron i pięć tematów artykułów. Przy tej okazji wyszła rzecz, która zmieniła sposób prezentacji całego kierunku.
Rozporządzenie o cudzoziemcach obowiązujące od maja 2025 roku wraz z odpowiednią instrukcją zamyka przejście ze statusu pobytu na kursie językowym na zezwolenie na pobyt i pracę. Jednocześnie zapytania o pobyt „przez kursy językowe” rosną — popyt jest, a uczciwie nie ma czego pod niego sprzedać.
Dlatego podstrona sprzedaje realną ścieżkę: rok języka, a potem studia magisterskie, zamiast furtki, której już nie ma. Sprawdzenie, co wolno obiecać, jest częścią pracy nad widocznością, a nie prawniczym dodatkiem: podstrona obiecująca niemożliwe przynosi zapytania, których agencja nie domknie.
Nowa struktura serwisu: 180 podstron dla dziewięciu krajów w jednym potoku Sanity
Najpierw model danych: słowniki krajów i uczelni, wspólny quiz, huby kierunków i ich podstrony, każda w wersji rosyjskiej i angielskiej, powiązanych ze sobą.
Potem mapa podstron. Każdy z dziewięciu nowych kierunków dostał 20 podstron: hub, wiza studencka, rekrutacja, studia magisterskie, praca w trakcie nauki i pięć kart uczelni, każda w dwóch językach. Dziewięć kierunków dało 180 podstron; razem ze wspólnymi przez potok przeszło 188.
Dla Hiszpanii mapa wygląda tak: huby /study-in-spain i /ru/ucheba-v-ispanii, pod nimi wiza, rekrutacja, studia magisterskie i praca, a obok karty UCAM, Universidad Europea, CEU San Pablo, Complutense i Uniwersytetu w Barcelonie.
Linkowanie między kierunkami i wewnątrz kierunku składają skrypty, a nie człowiek: linki krzyżowe, linki do hubów i audyt tego, co prowadzi donikąd.
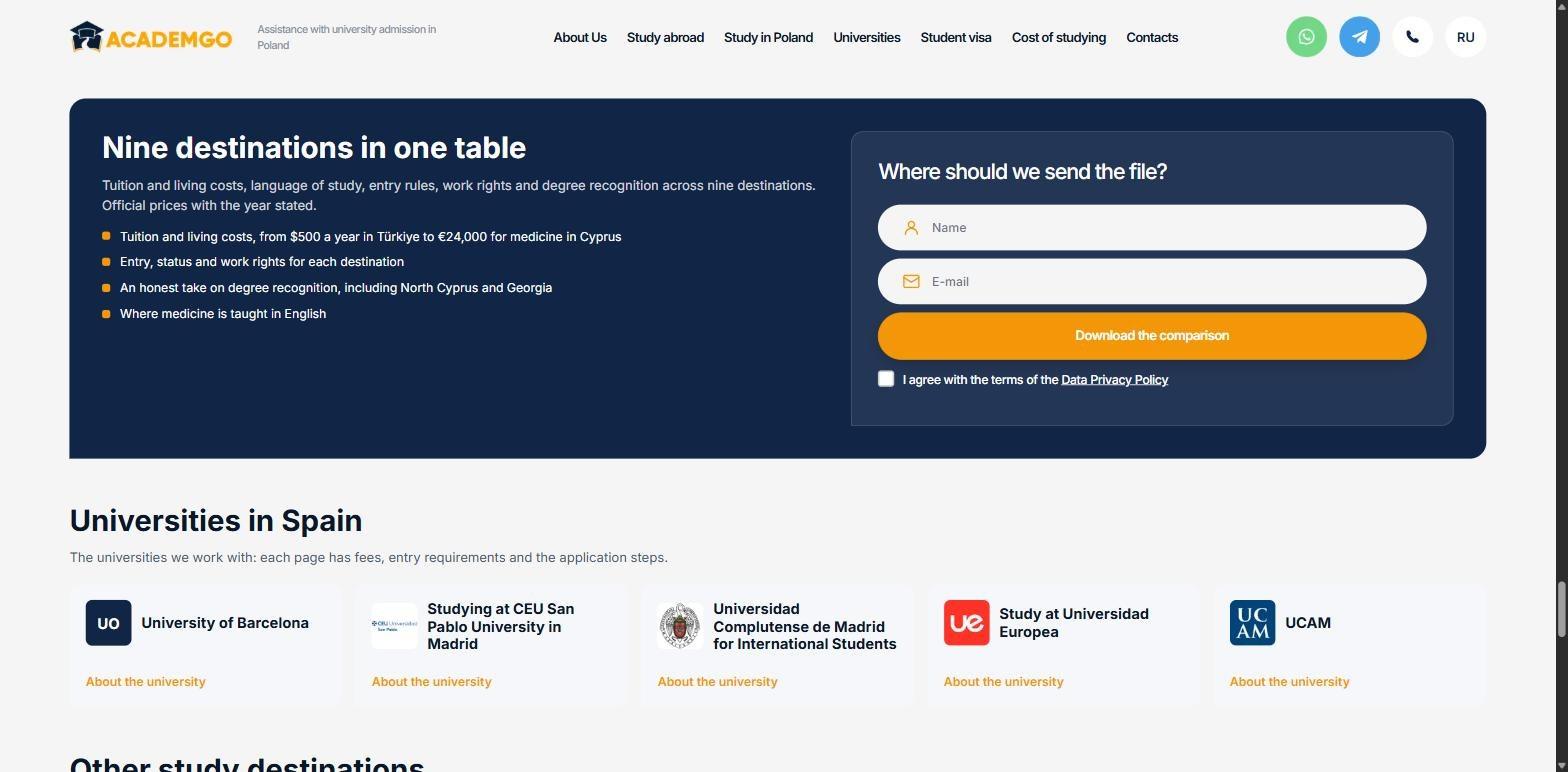
Ceny usług agencji zostały wyłącznie przy Polsce, bo tylko tam jest potwierdzony cennik; dla pozostałych kierunków nie zostały wymyślone. Koszty studiów i życia są podane dla każdego kraju, a każda liczba pochodzi ze sprawdzalnego źródła: strony uczelni, ministerstwa albo urzędu migracyjnego. Z tekstów usunięte zostały starzejące się odwołania do lat, żeby podstrony nie dezaktualizowały się same.
Strona główna i mega-menu po przejściu na dziesięć kierunków
Strona główna przestała być stroną o Polsce. Pojawił się blok kierunków i mega-menu na dziesięć krajów, przepisane zostały metadane strony głównej i bloga. Osobna strona porównania odpowiada na szerokie pytania o studia za granicą i jest wejściem dla tych, którzy wybierają jeszcze kraj, a nie uczelnię.
Punkty zbierania zapytań: quiz, pole „kraj studiów” i dziesięć poradników PDF
Nowa struktura jest bezużyteczna, jeśli czytelnik kończy podstronę i nie ma gdzie kliknąć.
Quiz jest wbudowany w nowe podstrony na dwie trzecie szerokości, obok panel z tym, co kandydat dostanie po wypełnieniu. Pole „kraj studiów” trafiło do wszystkich formularzy serwisu, do zapytań, do analityki i do samego quizu: bez niego handlowiec nie wie, z jakim kierunkiem przyszedł człowiek.
Lead magnety to pięć tematów w dwóch językach: porównanie dziewięciu kierunków, lista dokumentów, przygotowanie do IELTS, list motywacyjny oraz pytania, które warto zadać agencji przed wpłatą. Dziesięć PDF-ów składa z markdown skrypt, więc poprawka zdania nie kosztuje składu od nowa.
Infografika na podstronach kierunków i kontrola liczb skryptem
Na każdej nowej podstronie jest infografika: słupki, oś czasu albo mapa kraju. Istotne jest nie oprawa, lecz zasada: wszystkie liczby pochodzą z tekstu tej samej podstrony, a przed zapisem skrypt sprawdza zgodność liczb, współrzędne miast i linki do uczelni. Dzięki temu grafika nie zaczyna żyć własnym życiem obok tekstu.
Podstawa indeksacji: sitemap, hreflang i dane strukturalne organizacji
Warstwa, bez której reszta się nie liczy: mapa witryny, hreflang dla wersji rosyjskiej i angielskiej, okruszki nawigacji oraz noindex na domenach podglądowych i testowych. Dane strukturalne organizacji niosą logo, adres, kontakty i profile społecznościowe; podstrony niosą FAQPage i BreadcrumbList.
Przygotowanie serwisu do odpowiedzi AI: llms.txt generowany z tego samego CMS
Serwis udostępnia plik /llms.txt zgodny ze standardem llmstxt.org — markdownową mapę witryny dla asystentów i agentów AI. Sam pomysł jest powszechny; znaczenie ma sposób wykonania. Plik powstaje z tych samych dokumentów CMS co podstrony i odświeża się raz na dobę, więc serwis i mapa nie mogą się rozjechać.
Treść była przygotowana pod cytowanie równie świadomie. Każdy kierunek ma osobne podstrony o wizie, rekrutacji, studiach magisterskich i pracy, więc każde pytanie kandydata ma własną podstronę, a nie akapit. Za każdą uczelnią stoi zestaw sprawdzonych faktów. W FAQ siedzą pytania, które ludzie naprawdę zadają, aż po uznawalność dyplomu z Cypru Północnego w Kazachstanie.
Potok publikacji: deterministyczne identyfikatory i ponowne uruchomienie bez duplikatów
188 podstron nie da się wprowadzić ręcznie, a co ważniejsze nie wolno ich wprowadzić tak, by drugie uruchomienie mnożyło kopie. Każdy dokument ma deterministyczny identyfikator złożony z kierunku, podstrony i języka, więc ponowny przebieg nadpisuje te same dokumenty. Dopóki podstrony są wersjami roboczymi, linki między nimi rozwiązują się na wdrożeniu podglądowym, więc błędy widać przed publikacją, a nie po niej.
Na tym wszystkim skrypty QA: audyt linków, kontrola podstron i kontrola odwołań do lat w tekstach.
Jak mierzyłem efekt: pomiar pozycji 156 fraz przed publikacją
Przed publikacją zapisałem pozycje wyjściowe, żeby efekt dało się zmierzyć, a nie opisać słowami. DataForSEO Labs plus żywe wyniki na sześciu rynkach; pomiar kosztował 55 centów.
Wyszło tak: Polska — 18 fraz w pierwszej setce i ani jednej w pierwszej dziesiątce, Kazachstan — 7, Azerbejdżan — 13, Indie — 26, Pakistan — 8, Nigeria — 5. Dla Uzbekistanu, Kirgistanu, Rosji i Białorusi baza nie ma danych, więc sprawdziłem tam 24 zapytania ręcznie: ani jednego wejścia do pierwszej setki. Na 156 fraz docelowych nowych podstron domena nie rankowała w ogóle.
To jest uczciwe zero. Każdy wzrost po publikacji liczy się od niego, a nie od wrażenia.
Przyspieszenie serwisu: Next.js 16, rezygnacja z axios i odroczone ciężkie pola
Serwis urósł objętościowo i miał z tego wyjść szybszy, a nie wolniejszy. Przejście na Next.js 16, React 19 i Sanity 6; axios zastąpiony wbudowanym fetch we wszystkich formularzach i blokach, zależność usunięta z projektu; animacja menu mobilnego przepisana bez framer-motion; pole telefonu z ciężką biblioteką ładowane po załadowaniu strony, z przeniesieniem fokusu na właściwe pole; dziesięć dekoracyjnych SVG wyniesionych z kodu do komponentów; analityka ładowana po działaniu użytkownika, a nie na starcie; obrazy serwowane przez loader Sanity w odpowiednich rozmiarach; ikona serwisu zmniejszona ze 158 do 15 kilobajtów. Przy okazji powstała prawdziwa strona 404 zamiast zaślepki i naprawiona została hydratacja, którą psuły rozszerzenia przeglądarki.
PageSpeed przed i po: z 61 na 91 punktów w pomiarze mobilnym
Oba pomiary są mobilne i dotyczą tej samej podstrony.
Wydajność 61 przed i 91 po pracach. Dobre praktyki 96 i 100. SEO 92 i 100. Dostępność została na 97.
Ładowanie: pierwsze wyświetlenie treści 3,0 → 1,5 s, największy element 5,6 → 3,3 s, czas blokowania wątku 310 → 10 ms, przesunięcia układu 0,113 → 0,018, indeks szybkości 4,7 → 2,9 s. Test gotowości na agentów AI po pracach: 3 na 3.
Ile trwała przebudowa i kto ją wykonał
Serwis prowadzę od lipca 2024 roku: 334 commity, z czego 332 moje. Sprint przebudowy zajął pięć dni roboczych: 33 commity, 787 zmienionych plików, ponad sto tysięcy dodanych linii. Nowe podstrony zostały opublikowane naraz, a nie partiami.
Pracę wykonała jedna osoba, a nie zespół: semantyka, architektura, teksty, programowanie, dane strukturalne, przyspieszenie i pomiary. To zarejestrowana działalność, umowa i faktury, a odpowiedzialność za efekt leży po mojej stronie.
Efekt: ruch i zapytania według analityki klienta
Według analityki klienta za wrzesień 2026 ruch i liczba zapytań wzrosły wielokrotnie. Klient nie zgodził się na publikację liczb, więc podaję źródło i okres zamiast wartości.
Kontrolny pomiar pozycji dla tych samych 156 fraz został wykonany, ale jego liczby również nie są publikowane.
Czego w tym case study nie ma: jakie liczby są pominięte i dlaczego
Nie ma tu procentów wzrostu ruchu, liczby zapytań ani pozycji po publikacji: te dane należą do klienta, a on nie zgodził się na ich publikację. Nie ma też dat publikacji i pomiarów, z tego samego powodu.
Wszystko pozostałe w tym tekście to liczby z plików roboczych projektu: commity, liczba podstron, objętość eksportów, pozycje wyjściowe i wyniki PageSpeed. Jeśli jakiejś liczby nie ma, to dlatego, że nie da się jej potwierdzić — i nie zastępuje jej liczba wymyślona.